Bun / Benchmark
วัด Bun HTTP Framework บน MacBook Air M5
bun-http-framework-benchmark ของ SaltyAom เผยแพร่ผลจากเครื่องเดสก์ท็อป — Intel Core i7-13700K พร้อม DDR5 32 GB รัน Linux ผมไม่มีเครื่องนั้นครับ ผมมี MacBook Air — ไม่มีพัดลม เป็น ARM 10 คอร์ และเป็นเครื่องที่ผมเขียนโค้ดอยู่จริง ๆ
เพราะฉะนั้นคำถามที่ผมอยากได้คำตอบจึงไม่ใช่ “framework ไหนเร็วที่สุด” เพราะมีคนเผยแพร่ไว้แล้ว และการเพิ่มตารางอีกหนึ่งใบมายืนยันก็ไม่คุ้มเวลาใคร คำถามจริง ๆ คือ:
โน้ตบุ๊กที่ระบายความร้อนแบบ passive เสีย throughput ไปเท่าไหร่เมื่อเทียบกับเดสก์ท็อป?
ผมเดาว่าคำตอบจะเป็นเปอร์เซ็นต์คงที่ตัวเดียว แต่ไม่ใช่ครับ
ทุกตัวเลขข้างล่างเป็นค่าเฉลี่ยจากการวัด 5 ครั้งต่อ framework แต่ละครั้งอยู่ใน process ของตัวเอง และสลับลำดับการวัดใหม่ทุกรอบ ฟังดูเหมือนทำเกินไปสำหรับ benchmark บนโน้ตบุ๊ก — แต่ไม่เลยครับ เพราะวิธีรันชุดทดสอบนี้แบบตรงไปตรงมาที่สุด มันวัด สภาพความร้อนของเครื่อง แทบจะมากเท่ากับที่วัดตัว framework และผมรู้เรื่องนี้ก็เพราะผลลัพธ์รอบแรกมันออกมา “สวยเกินไป” เรื่องนี้เป็นสิ่งที่มีประโยชน์ที่สุดในโพสต์นี้ ผมจึงเอาขึ้นมาก่อน
เครื่องที่ใช้ทดสอบ
| รุ่น | MacBook Air (Mac17,3) |
| ชิป | Apple M5 — 10 คอร์, 4 performance + 6 efficiency |
| แรม | 24 GB unified |
| ระบบปฏิบัติการ | macOS 26.6.2 (25G83) |
| Bun | 1.4.0 |
| bombardier | 2.0.2 darwin/arm64 |
| อุณหภูมิห้อง | 25 °C |
ลิงก์ชื่อรุ่นด้านบนเป็นลิงก์ Lazada affiliate ครับ กดซื้อผ่านลิงก์นี้ราคาไม่ต่างจากเดิม แต่บล็อกจะได้ค่าคอมมิชชันเล็กน้อย
รันโดยเสียบปลั๊กไฟ ปิด editor และ dev server ทั้งหมด และ pmset -g therm ไม่รายงาน thermal หรือ performance warning ทั้งก่อนและหลังทุกรอบ
ผมใส่อุณหภูมิห้องไว้ด้วยเพราะบนเครื่องที่ไม่มีพัดลม มันเป็นพารามิเตอร์จริง ไม่ใช่เกร็ดประดับ โน้ตบุ๊กเครื่องนี้ไม่มีพัดลมมาชดเชยห้องที่ร้อน ทางเลือกที่มันเหลือคือซับความร้อนเข้าตัวเครื่องแล้วลดความเร็วลง — และมันลดจริง ส่วนการหาว่าลดไปเท่าไหร่กลายเป็นเรื่องที่สนุกที่สุดของงานนี้ ถ้าเอาชุดทดสอบเดิมไปรันในห้อง 32 °C ผมไม่คาดว่าตัวเลขเหล่านี้จะยังใช้ได้
benchmark นี้วัดอะไรจริง ๆ
สี่ route ยิงด้วย bombardier --fasthttp 10 วินาที ที่ 500 connections พร้อมกัน ยกเว้นตัวสุดท้ายที่มีเหตุผลให้ต่างออกไป:
- Ping —
GET /ตอบHiเป็นtext/plainเป็นพื้น: หนึ่งรอบ request/response ถูกแค่ไหน - Query —
GET /id/1?name=bunตอบ1 bunมีทั้ง path parameter และ query parameter ที่ต้องดึงค่าแบบ dynamic เพราะชุดทดสอบห้าม hardcode การตัดสตริงไว้ชัดเจน ตรงนี้จึงวัด router กับ query parser ที่ทำงานจริง - Body —
POST /jsonรับ{"hello":"world"}parse เป็น JSON แล้ว serialize กลับ ไม่ใช่การ echo ไบต์ แต่วิ่งผ่าน parser จริงทั้งรอบ - Video —
GET /videoสตรีมไฟล์ MP4 ขนาด 14.1 MB ตัวนี้รันที่ 10 connections ไม่ใช่ 500 และส่งCache-Control: no-storeพร้อมIf-None-Matchที่ตั้งใจให้ไม่ตรง เพื่อให้ server ตัดตอนด้วย 304 ไม่ได้ ทุก request จึงส่งไฟล์ทั้งก้อน
แต่ละ framework ยังลงทะเบียน route พื้นหลังอีกราว ๆ ยี่สิบเส้นที่ไม่ถูกเรียกเลย เพื่อให้ router มีตารางให้ค้นหาสมจริง ไม่ใช่ตารางเปล่า ๆ
ก่อนยิงโหลดทุกครั้ง ตัว harness จะเปิด server แล้วตรวจ response body และ header ทุกอัน framework ที่ตอบผิดจะไม่ได้ตัวเลข — มันจะได้ error ครับ
ทำไมทดสอบแค่ Bun
ชุดทดสอบต้นทางครอบคลุม Bun, Node และ Deno แต่ผมรันแค่ฝั่ง Bun เพราะ Bun คือสิ่งที่ผมใช้จริง Node กับ Deno ไม่ได้ติดตั้งบนเครื่องนี้ และผมไม่มีเหตุผลจะลงเพิ่มเพื่องานนี้ — “Bun เทียบ Node” เป็นอีกคำถามหนึ่ง ซึ่ง README ต้นทางตอบไว้แล้ว สิ่งที่ผมอยากรู้คือการเทียบ ภายใน Bun บนฮาร์ดแวร์ของผมเอง
แต่มีหลุมพรางหนึ่งที่ควรเตือนคนที่จะทำซ้ำบนเครื่องที่มีแต่ Bun ครับ ผมคาดว่า target ฝั่ง Node จะ fail ไปเงียบ ๆ และฝั่ง Deno ก็ fail จริง — Executable not found in $PATH: "deno" แต่ target ฝั่ง Node ส่วนใหญ่กลับรันได้ เพราะ Bun shim คำสั่ง node ให้ child process แบบโปร่งใส ถ้าปล่อยไว้ การรันครั้งนั้นจะได้ตารางตัวเลขหน้าตาน่าเชื่อถือที่ติดป้ายว่า node ทั้งที่จริงคือ Bun รัน bundle ที่คอมไพล์มาเพื่อ Node
นั่นเป็นฟีเจอร์ที่ดี แต่เป็นผล benchmark ที่แย่มาก เพราะฉะนั้น: แปด target ฝั่ง Bun ระบุชื่อชัด ๆ
bun/elysia  bun/elysia-aot  bun/hono  bun/bun
bun/bun-web-standard  bun/h3  bun/effect  bun/express
bun/fastify มีอยู่ใน source tree แต่ติด blacklist ของต้นทาง จึงไม่รวมในนี้
สิ่งที่ดูเหมือนควรทำคือโยนรายการทั้งหมดให้ runner รันทีเดียว อย่าทำครับ และเหตุผลที่ว่าทำไม ก็กลายเป็นเรื่องที่ผมได้เรียนรู้มากที่สุดจากงานนี้
เวอร์ชันที่ทดสอบ
benchmark ที่ไม่บอกเลขเวอร์ชันมีอายุใช้งานประมาณหนึ่งสัปดาห์ ดังนั้น:
| Target | Package | Version |
|---|---|---|
| elysia | elysia |
2.0.0-beta.4 |
| elysia-aot | elysia ผ่าน elysia/plugin/aot/bun |
2.0.0-beta.4 |
| hono | hono |
4.13.1 |
| bun | Bun.serve — ไม่มี framework |
Bun 1.4.0 |
| bun-web-standard | Bun.serve handler แบบ Web-standard |
Bun 1.4.0 |
| h3 | h3 |
2.0.1-rc.26 |
| effect | effect + @effect/platform-bun |
4.0.0-beta.102 |
| express | express |
5.2.1 |
ก่อนจะตีความลำดับอะไร สิ่งที่ควรสังเกตคือ สามในแปดตัวเป็น pre-release — Elysia เป็น beta, h3 เป็น release candidate, Effect เป็น beta ส่วน elysia-aot ไม่ใช่แพ็กเกจแยก มันคือ Elysia ตัวเดียวกันที่รันผ่าน plugin คอมไพล์ล่วงหน้า ซึ่งเป็นเหตุผลที่สองแถวนี้เกาะกันแทบติด และทั้งสองรายการของ bun เป็นตัว runtime เองไม่ใช่ dependency จึงเวอร์ชันไปตาม Bun
ตัวเลขจากซอฟต์แวร์ pre-release เป็นแค่ภาพนิ่งของเป้าที่ยังเคลื่อนอยู่ โดยเฉพาะ Elysia 2.0 ที่อาจหน้าตาต่างไปเมื่อปล่อยตัวจริง
benchmark กำลังวัดโน้ตบุ๊กของผม ไม่ได้วัด framework
runner ต้นทางรับรายการ target แล้ววัดไล่กันไปทีละตัวภายใน process เดียว แปด framework สี่ route จบในราวห้านาทีครึ่ง การรันรอบแรกของผมให้ผลตรงตามที่ใคร ๆ หวัง: ตารางสะอาด มั่นใจ เรียงอันดับชัดเจน Elysia มาก่อน express อยู่ท้าย ทุกตัวเว้นระยะกันสวยงาม
ผมเกือบเผยแพร่ไปแล้วครับ สิ่งที่ฉุดผมไว้คือความเอะใจเรื่องรูปร่างของมัน — บนโน้ตบุ๊กไม่มีพัดลม การยิงโหลดต่อเนื่องห้านาทีมีเส้นโค้งความร้อนของมันอยู่ และ framework ที่ถูกวัดตอนปลายเส้นโค้งนั้น ไม่ได้ถูกวัดในเงื่อนไขเดียวกับตัวที่ถูกวัดตอนต้น
ผมจึงรันใหม่หนึ่งรอบโดย กลับลำดับรายการ target เครื่องเดิม cooldown เดิม อุณหภูมิห้องเดิม สิ่งเดียวที่เปลี่ยนคือลำดับ
| Framework | ตำแหน่ง (ไป → กลับ) | ไปตามลำดับ | กลับลำดับ | เปลี่ยนแปลง |
|---|---|---|---|---|
| elysia | 1 → 8 | 138,045 | 117,395 | −15.0% |
| elysia-aot | 2 → 7 | 133,837 | 117,188 | −12.4% |
| hono | 3 → 6 | 125,960 | 115,337 | −8.4% |
| bun | 4 → 5 | 125,108 | 120,675 | −3.5% |
| bun-web-standard | 5 → 4 | 120,905 | 120,195 | −0.6% |
| h3 | 6 → 3 | 119,983 | 124,680 | +3.9% |
| effect | 7 → 2 | 92,226 | 97,571 | +5.8% |
| express | 8 → 1 | 55,080 | 59,650 | +8.3% |
ความเปลี่ยนแปลงไปตามระยะที่แต่ละ framework ย้ายที่แบบตรงไปตรงมา ตัวที่เลื่อนไปท้ายช้าลงหมด ตัวที่เลื่อนมาต้นเร็วขึ้นหมด และขนาดของความเปลี่ยนแปลงไปตามขนาดของการย้าย throughput ตกลงราว 15% จากช่องแรกถึงช่องสุดท้ายภายในรอบเดียว
ในรอบที่กลับลำดับ Elysia ได้ 117,395 ส่วน h3 ได้ 124,680 — Elysia แพ้ครับ ซึ่งตรงข้ามกับผลที่ผมกำลังจะเผยแพร่ โดยเกิดจากการไม่เปลี่ยนอะไรเลยนอกจากลำดับของ argument ใน command line
pmset -g therm ไม่รายงาน thermal หรือ performance warning ใด ๆ ระหว่างนี้เลย บนเครื่องนี้การเช็กนั้นบอกอะไรที่ใช้ได้ไม่ได้เลย และผมเคยเอาความเงียบของมันมาใช้เป็นหลักฐาน
สิ่งที่ยังอยู่ไม่ว่าลำดับจะเป็นอย่างไร: express อยู่ท้ายสุดและ effect อยู่อันดับรองท้ายในทุกการตั้งค่าที่ผมรัน ด้วยระยะห่างที่ไม่มีตัวอื่นเข้าใกล้ ปัญหาอยู่ที่ กลุ่มเร็ว — ทุกตัวระหว่างราว 115k ถึง 138k — ที่ตำแหน่งการวัดกลบความต่างจริงของ framework จนมิด
วิธีแก้
วัดแต่ละ framework ใน invocation ของตัวเอง บนเครื่องที่เย็นเท่ากัน และสลับลำดับใหม่ทุกรอบ เพื่อให้ความคลาดที่ยังเหลือกลายเป็น noise แทนที่จะเป็นอคติเป็นระบบที่เข้าข้างตัวที่ได้รันก่อน
นั่นหมายถึงหนึ่ง process ต่อการวัดหนึ่งครั้ง, cooldown 75 วินาทีระหว่างทุกช่อง และห้ารอบ โดยแต่ละรอบ shuffle ด้วย seed ของตัวเอง รวม 40 การวัด ใช้เวลาเครื่องราว 77 นาที เทียบกับห้านาทีครึ่งของวิธีง่าย ๆ งานทั้งหมดรันใต้ caffeinate -dimsu — ความพยายามแบบไม่เฝ้าหน้าจอครั้งก่อนถูกทำลายเงียบ ๆ เพราะ Mac หลับไปกลางทาง แล้วการวัดหลังจากนั้นออกมาต่ำกว่าความจริงราว 39%
ทุกอย่างข้างล่างมาจากวิธีนี้ครับ
ผลลัพธ์
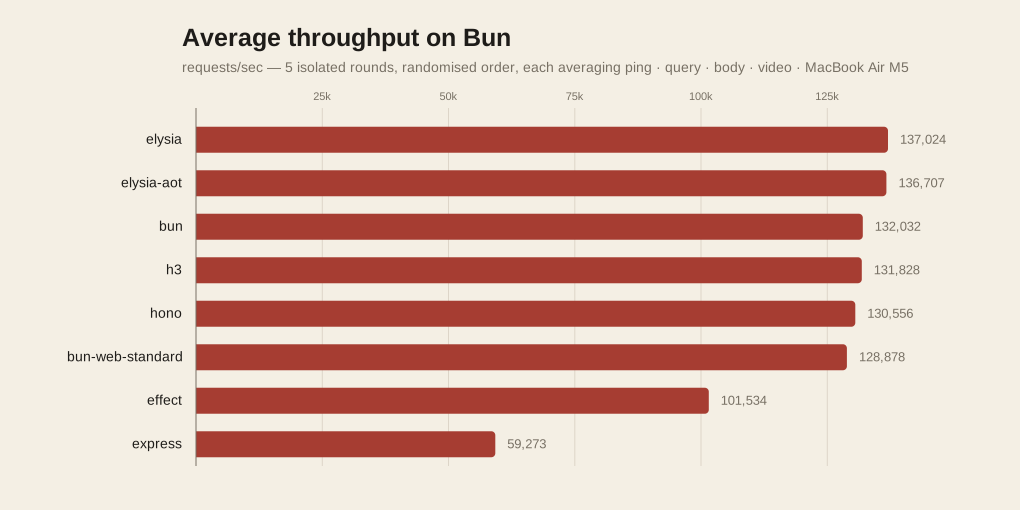
Request ต่อวินาที เฉลี่ยทั้งสี่ route แล้วเฉลี่ยอีกครั้งจากห้ารอบที่แยกกัน
| Framework | เฉลี่ย | Ping | Query | Body | Video | Bundle | Startup | Memory หลังโหลด |
|---|---|---|---|---|---|---|---|---|
| elysia | 137,024 | 200,017 | 179,739 | 167,496 | 844 | 171.4 KB | 11.5 ms | 56 MB |
| elysia-aot | 136,707 | 198,962 | 179,868 | 167,152 | 847 | 127.5 KB | 10.7 ms | 54 MB |
| bun | 132,032 | 180,761 | 181,294 | 165,230 | 841 | 2.3 KB | 6.2 ms | 52 MB |
| h3 | 131,828 | 187,835 | 174,552 | 164,080 | 843 | 22.5 KB | 7.9 ms | 60 MB |
| hono | 130,556 | 189,171 | 171,382 | 160,827 | 846 | 20.4 KB | 8.2 ms | 56 MB |
| bun-web-standard | 128,878 | 180,285 | 167,522 | 166,862 | 843 | 1.7 KB | 6.2 ms | 51 MB |
| effect | 101,534 | 157,972 | 138,202 | 109,140 | 823 | 263.2 KB | 27.2 ms | 82 MB |
| express | 59,273 | 90,901 | 76,993 | 68,861 | 338 | 822.8 KB | 29.8 ms | 208 MB |
ควรเอาไปวางข้างตัวเลขแบบรันไล่กันที่ผมเกือบเผยแพร่ด้วย เพราะการแก้ไม่ได้เกิดขึ้นเท่ากันทุกตัว — มันเป็นฟังก์ชันของตำแหน่งที่แต่ละ framework เคยนั่งอยู่ในลำดับเดิมแบบเกือบสมบูรณ์:
| Framework | ช่องเดิม | ค่าเฉลี่ยแบบรันไล่ | ค่าเฉลี่ยแบบแยก | เปลี่ยนแปลง |
|---|---|---|---|---|
| elysia | 1 | 136,966 | 137,024 | +0.0% |
| elysia-aot | 2 | 131,288 | 136,707 | +4.1% |
| hono | 3 | 121,215 | 130,556 | +7.7% |
| bun | 4 | 123,131 | 132,032 | +7.2% |
| bun-web-standard | 5 | 119,195 | 128,878 | +8.1% |
| h3 | 6 | 121,272 | 131,828 | +8.7% |
| effect | 7 | 91,875 | 101,534 | +10.5% |
| express | 8 | 55,156 | 59,273 | +7.5% |
ตัวเลขของ Elysia ไม่ขยับ เพราะ Elysia ถูกวัดเป็นตัวแรกเสมอ ส่วน framework อื่นทั้งหมดถูกคิดค่าความร้อนที่ตัวเองไม่ได้สร้าง โดยประมาณตามระยะเวลาที่ต้องรอคิว express เป็นปลายที่ยังค้างอยู่ — มันได้เพิ่มน้อยกว่าที่ตำแหน่งควรจะทำนายได้ และผมยังไม่มีคำอธิบายที่ตัวเองเชื่อถือ
รอบที่แยกกันเหล่านี้ยังรันในห้อง 25 °C เทียบกับ 22 °C ของรอบที่รันไล่กัน ห้องที่ร้อนกว่าควรกด throughput ลง ดังนั้นขนาดจริงของอคติจากตำแหน่งน่าจะใหญ่กว่าที่ตารางนี้แสดงเล็กน้อยด้วยซ้ำ
ตัวเลขเหล่านี้แกว่งแค่ไหน?
| Framework | Mean | Std dev | CV | Min | Max |
|---|---|---|---|---|---|
| elysia | 137,024 | 965 | 0.7% | 136,121 | 138,156 |
| elysia-aot | 136,707 | 806 | 0.6% | 135,864 | 137,839 |
| bun | 132,032 | 1,059 | 0.8% | 131,028 | 133,689 |
| h3 | 131,828 | 716 | 0.5% | 130,981 | 132,959 |
| hono | 130,556 | 612 | 0.5% | 129,933 | 131,575 |
| bun-web-standard | 128,878 | 776 | 0.6% | 127,954 | 129,699 |
| effect | 101,534 | 507 | 0.5% | 100,886 | 102,236 |
| express | 59,273 | 645 | 1.1% | 58,219 | 59,860 |
ก่อนจะตีความลำดับอะไร สิ่งที่ต้องเช็กคือ การสุ่มลำดับกำจัดอคติจากตำแหน่งได้จริงไหม? เมื่อ normalize ทุกการวัดด้วยค่าเฉลี่ยของ framework ตัวเอง แล้วหา correlation กับช่องที่ถูกวัด ได้ r = +0.09 ค่า throughput แบบ normalize เฉลี่ยตามช่อง:
| ช่อง | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 99.9% | 100.0% | 100.1% | 100.1% | 99.9% | 99.5% | 99.9% | 100.6% |
แบนราบ อยู่ในช่วงไม่เกินหนึ่งเปอร์เซ็นต์ทั้งรอบ เทียบกับ runner แบบรันไล่กันที่ช่อง 8 ต่ำกว่าช่อง 1 ราว 15% — การแยกการวัดได้ผลครับ
เมื่อยืนยันเรื่องนั้นแล้ว นี่คือสิ่งที่ตารางนี้รองรับและไม่รองรับ:
- Elysia กับ elysia-aot เสมอกัน ห่างกัน 317 req/s บนฐาน 137,000 ซึ่งอยู่ในหนึ่ง standard deviation สบาย ๆ plugin AOT ไม่ได้เร็วกว่าอย่างวัดได้ในที่นี้ แต่มันลด bundle จาก 171.4 KB เหลือ 127.5 KB ซึ่งอาจสำคัญกว่า
bunกับ h3 เสมอกัน ห่างกัน 204 req/s ไม่มีลำดับระหว่างสองตัวนี้- hono อยู่ต่ำกว่าทั้งสองตัวเล็กน้อย ราว 1,300 req/s หรือประมาณสอง standard deviation มีจริง แต่เฉียดฉิว
- bun-web-standard เป็นที่โหล่ของกลุ่มเร็วหกตัวจริง ๆ ตามหลัง
bunราว 2.4% - effect กับ express เป็นอันดับเจ็ดและแปดในทุกรอบ และไม่ได้ใกล้กันเลย
กลุ่มเร็วทั้งหมดกินช่วง 6.3% จาก 128,878 ถึง 137,024 ซึ่งแคบกว่าที่การรันไล่กันทำให้เข้าใจไปมาก เพราะสิ่งที่ดูเหมือนระยะห่างระหว่างหกตัวนี้ ส่วนใหญ่คือเส้นโค้งความร้อน
ข้อสรุปที่ผมยืนยันได้: bun ในตารางนี้คือ Bun.serve ที่ไม่มี framework เลย — routing เขียนมือ query parsing เขียนมือ มีสอง framework ที่ชนะมัน อีกสองตัวอยู่ในระยะ 1.5% และตัวที่ช้าที่สุดของหกตัวตามหลังแค่ 2.4% นามธรรมของ routing ไม่มีค่าใช้จ่ายครับ
ขอเปิดเผยว่าผมเคยมีส่วนร่วมกับเอกสารของ Elysia ดังนั้นความตื่นเต้นของผมกับแถวบนสุดควรถูกหักลบตามสมควร และผลนี้ก็ไม่น่าประหลาดใจด้วย เพราะ Elysia สร้าง route handler ล่วงหน้า ซึ่งตรงกับสิ่งที่ benchmark แบบนี้ให้รางวัลพอดี แต่สิ่งที่มัน ไม่ บอกคือแอปจริงจะเป็นอย่างไรเมื่อ handler ต้องแตะฐานข้อมูล และถึงจุดนั้น ระยะห่างของหกตัวบนจะเป็นแค่ noise เทียบกับ query planner ของคุณ
ท้ายตารางก็ควรมองแยกด้วย express ช้ากว่า Elysia 2.3 เท่า แบก bundle 822.8 KB และใช้ RSS 208 MB หลังโหลด เทียบกับ 56 MB ของ Elysia ถ้าคุณกำลังย้ายแอป Express มาอยู่บน Bun แล้วคาดว่า runtime จะแก้เรื่อง throughput ให้ — runtime ช่วยได้ครับ แต่ตัวที่กินคุณอยู่คือ framework
เทียบกับเดสก์ท็อป
นี่คือส่วนที่ผมรัน benchmark นี้ขึ้นมาเพื่อมันจริง ๆ ค่าเฉลี่ยแบบแยกของผมเทียบกับตัวเลขใน README ต้นทางจากเดสก์ท็อป i7-13700K:
| Framework | M5 Air | i7-13700K | M5 เป็น % ของเดสก์ท็อป |
|---|---|---|---|
| elysia | 137,024 | 209,850 | 65% |
| elysia-aot | 136,707 | 209,333 | 65% |
| bun | 132,032 | 163,149 | 81% |
| hono | 130,556 | 160,703 | 81% |
| bun-web-standard | 128,878 | 148,887 | 87% |
| h3 | 131,828 | 150,884 | 87% |
| express | 59,273 | 56,130 | 106% |
| effect | 101,534 | 90,077 | 113% |
โน้ตบุ๊กไม่ได้ช้ากว่าแบบสม่ำเสมอครับ มันเสีย throughput ไปราวหนึ่งในสามบน framework ที่เร็วที่สุด แต่กลับ เร็วกว่า เดสก์ท็อปบน effect และ express ช่วงนั้น — 65% ถึง 113% — กว้างกว่า noise ระหว่างรอบเป็นร้อยเท่า
ผมอยากเน้นว่าข้อสรุปนี้รอดจากการเปลี่ยนวิธีวัดมาได้ เพราะมันอาจไม่รอดก็ได้ ตัวเลขที่ปนเปื้อนบอกว่า 63%–102% ตัวเลขที่สะอาดบอกว่า 65%–113% รูปร่างเหมือนกันและผลแรงขึ้นเล็กน้อย แต่ผมรู้เรื่องนี้ได้เพราะคำนวณใหม่ ไม่ใช่เพราะเดาเอาว่าเหมือนเดิม
ลำดับนี้ตรงข้ามกับสัญชาตญาณ แต่มันสมเหตุสมผลเมื่อดูว่าเวลาหมดไปกับอะไร ตอน framework บาง งานส่วนใหญ่ต่อ request คือ HTTP stack — syscall, loopback, การจัดการ connection — ซึ่งเป็นที่ที่ความเร็วสัญญาณนาฬิกาและระบบหน่วยความจำของเดสก์ท็อปชนะ ขณะที่ตัวยิงโหลดของผมก็กำลังแย่ง 10 คอร์เดียวกันกับ server ที่กำลังทดสอบอยู่ แต่ตอน framework หนัก เวลาต่อ request ถูกครอบด้วยการรัน JavaScript ใน handler และ single-core ของ M5 สู้ 13700K ได้สบายในเรื่องนั้น
พูดตรง ๆ คือ ยิ่ง framework เร็ว ฮาร์ดแวร์ยิ่งมีผล ส่วน express ช้าพอที่จะกลบความต่างระหว่างโน้ตบุ๊กกับเดสก์ท็อปไปทั้งหมด
คอลัมน์ video เป็นข้อยกเว้นของคำอธิบายที่ผมเพิ่งให้ไป และผมอยากชี้ไว้มากกว่าเก็บซ่อน หกในแปด target ได้ 1,530–1,735 req/s ที่ต้นทาง เทียบกับ 823–847 ของผม — โน้ตบุ๊กเสียไปราวครึ่ง ซึ่งกว้างกว่า route อื่นมาก ส่วนอีกสองตัวไปทางตรงข้าม: h3 ของต้นทางทำได้แค่ 272 req/s บน video ขณะที่ของผมเฉลี่ย 843 และ express ได้ 263 เทียบกับ 338 ของผม ผมอธิบายทั้งสองทิศจากการรันเหล่านี้ไม่ได้ จึงขอให้ถือว่าคอลัมน์ video ทั้งคอลัมน์เป็นคำถามที่ยังเปิดอยู่ ไม่ใช่ข้อค้นพบ
สิ่งที่ผมขอเตือนไว้
- นี่คือเครื่องเดียว ห้ารอบบอกระดับ noise ระหว่างรอบของโน้ตบุ๊ก เครื่องนี้ เท่านั้น ไม่ได้บอกว่า M5 เครื่องอื่นหรือเครื่องที่มีพัดลมจะเป็นอย่างไร
- ตัวยิงโหลดใช้เครื่องร่วมกับ server bombardier กับ framework แย่ง 10 คอร์เดียวกัน เรื่องนี้บีบทุกอย่างเข้าหากัน และบีบ framework ที่เร็วหนักที่สุด ซึ่งเป็นส่วนหนึ่งที่ทำให้อัตราส่วนเดสก์ท็อปต่อโน้ตบุ๊กของผมไม่ใช่อัตราส่วนฮาร์ดแวร์ที่สะอาด
- มันคือโน้ตบุ๊กที่รัน OS ของเดสก์ท็อป Spotlight, Time Machine และอะไรก็ตามที่ macOS ตัดสินใจทำในสิบวินาทีนั้น อยู่ในตัวเลขทั้งหมด และนั่นคือที่มาส่วนใหญ่ของ ±1%
- เรื่องความร้อนถูกจัดการ ไม่ได้ถูกกำจัด การแยกการวัดและสุ่มลำดับทำให้ความคลาดจากความร้อนไม่สัมพันธ์กับตัว framework แต่ไม่ได้ทำให้โน้ตบุ๊กเลิกลดความเร็ว framework ที่ถูกวัดบนเครื่องร้อนก็ยังช้ากว่า เพียงแต่ไม่ใช่ framework กลุ่มเดิมที่ได้เครื่องร้อน อย่างเป็นระบบ อีกต่อไป และอย่าเชื่อ
pmset -g thermว่าจะบอกคุณตอนเรื่องนี้เกิดขึ้น มันเงียบตลอดช่วงที่ throughput ตกไป 15% - handler ใน benchmark ว่างเปล่า ทุก route ในนี้ตอบกลับทันที วินาทีที่ handler ต้องรอฐานข้อมูล ความต่างเหล่านี้จะหดเข้าใกล้ความไม่สำคัญ
ทำซ้ำตามนี้
git clone https://github.com/saltyaom/bun-http-framework-benchmark
cd bun-http-framework-benchmark
bun install
bun run verify   # เปิดทุก framework แล้วตรวจ route
แล้ววัดทีละ framework แทนที่จะโยนให้ runner ทั้งแปดตัว:
caffeinate -dimsu bun bench.ts bun/elysiacooldown 75 วินาที ทำตัวถัดไป และสลับลำดับใหม่ทุกรอบ สคริปต์ runner ของผมคือ zsh สามสิบบรรทัดที่ครอบ loop นั้นไว้ มีสามเรื่องที่กินเวลาผมไป:
runner ลบไดเรกทอรี results/ ทั้งอันทุกครั้งที่เริ่มทำงาน เมื่อรันหนึ่ง framework ต่อหนึ่งครั้ง หมายความว่าคุณต้องคัดลอกผลออกมาก่อนเริ่มตัวถัดไป ไม่งั้นจบงานจะเหลือแถวเดียว
results/results.md ไม่มี newline ปิดท้าย การต่อแถวด้วย >> จึงเอาไปต่อกันในบรรทัดเดียว แก้ด้วย printf '%s\n' "$(sed -n '3p' results/results.md)"
ครอบงานทั้งหมดด้วย caffeinate -dimsu ถ้ารันแบบไม่เฝ้า เครื่องจะหลับ และการวัดหลังตื่นจะต่ำกว่าความจริงราว 39% — สม่ำเสมอพอที่จะดูเหมือนข้อมูลจริงมากกว่าดูเหมือนความผิดพลาด
และขอให้ตรวจสมมติฐานเรื่องลำดับก่อนเผยแพร่ครับ การรันชุดทดสอบนี้แบบไล่กันรอบเดียวให้ตารางที่สะอาด มั่นใจ เรียงอันดับชัดเจน และบนเครื่องที่ไม่มีพัดลม ส่วนหนึ่งของลำดับนั้นคือผลพลอยได้ของความร้อน ผมไม่มีทางรู้เรื่องนี้จากการรันรอบเดียว — ผมคงเผยแพร่มันไปแล้ว
README ต้นทางพูดไว้ดีที่สุด: รันบนเครื่องของคุณเอง เพราะประสิทธิภาพต่างกันไปในแต่ละเครื่อง ซึ่งกลายเป็นเรื่องจริงในแบบที่น่าสนใจกว่าที่ผมคาดไว้ — เพราะมันต่างกัน ภายในเครื่องเดียว ด้วย ขึ้นอยู่กับว่าคุณวัดอะไรไปเมื่อห้านาทีก่อน